The GFS Paper
终于我们来到了The Google File System!如果还有印象的话,应该记得前面Bigtable就使用GFS来存储日志和数据文件,这下总算能一探究竟了。
设计架构
GFS 的设计建立在如下几个观察到的现象或假设上:
- 不论什么原因,组件崩溃必然会出现,所以,监控、容错、自愈是系统必备的能力;
- 存储几个集中的大文件比存储许多个小文件的情况更加常见,两者都要支持,但前者要额外优化;
- 大批量的流式读比小规模的随机读更常见,关注性能的应用基本都会把小规模的读操作组织到一起,减少来回读取的开销;
- 追加写比覆写更加常见,一旦写入,这个位置的数据就很少再被修改了;
- 需要支持并发追加写的使用场景;
- 高带宽的优先级高于低时延,如果要做选择,大多数应用倾向于能更快地处理数据,而非快速响应某一个读 / 写请求。
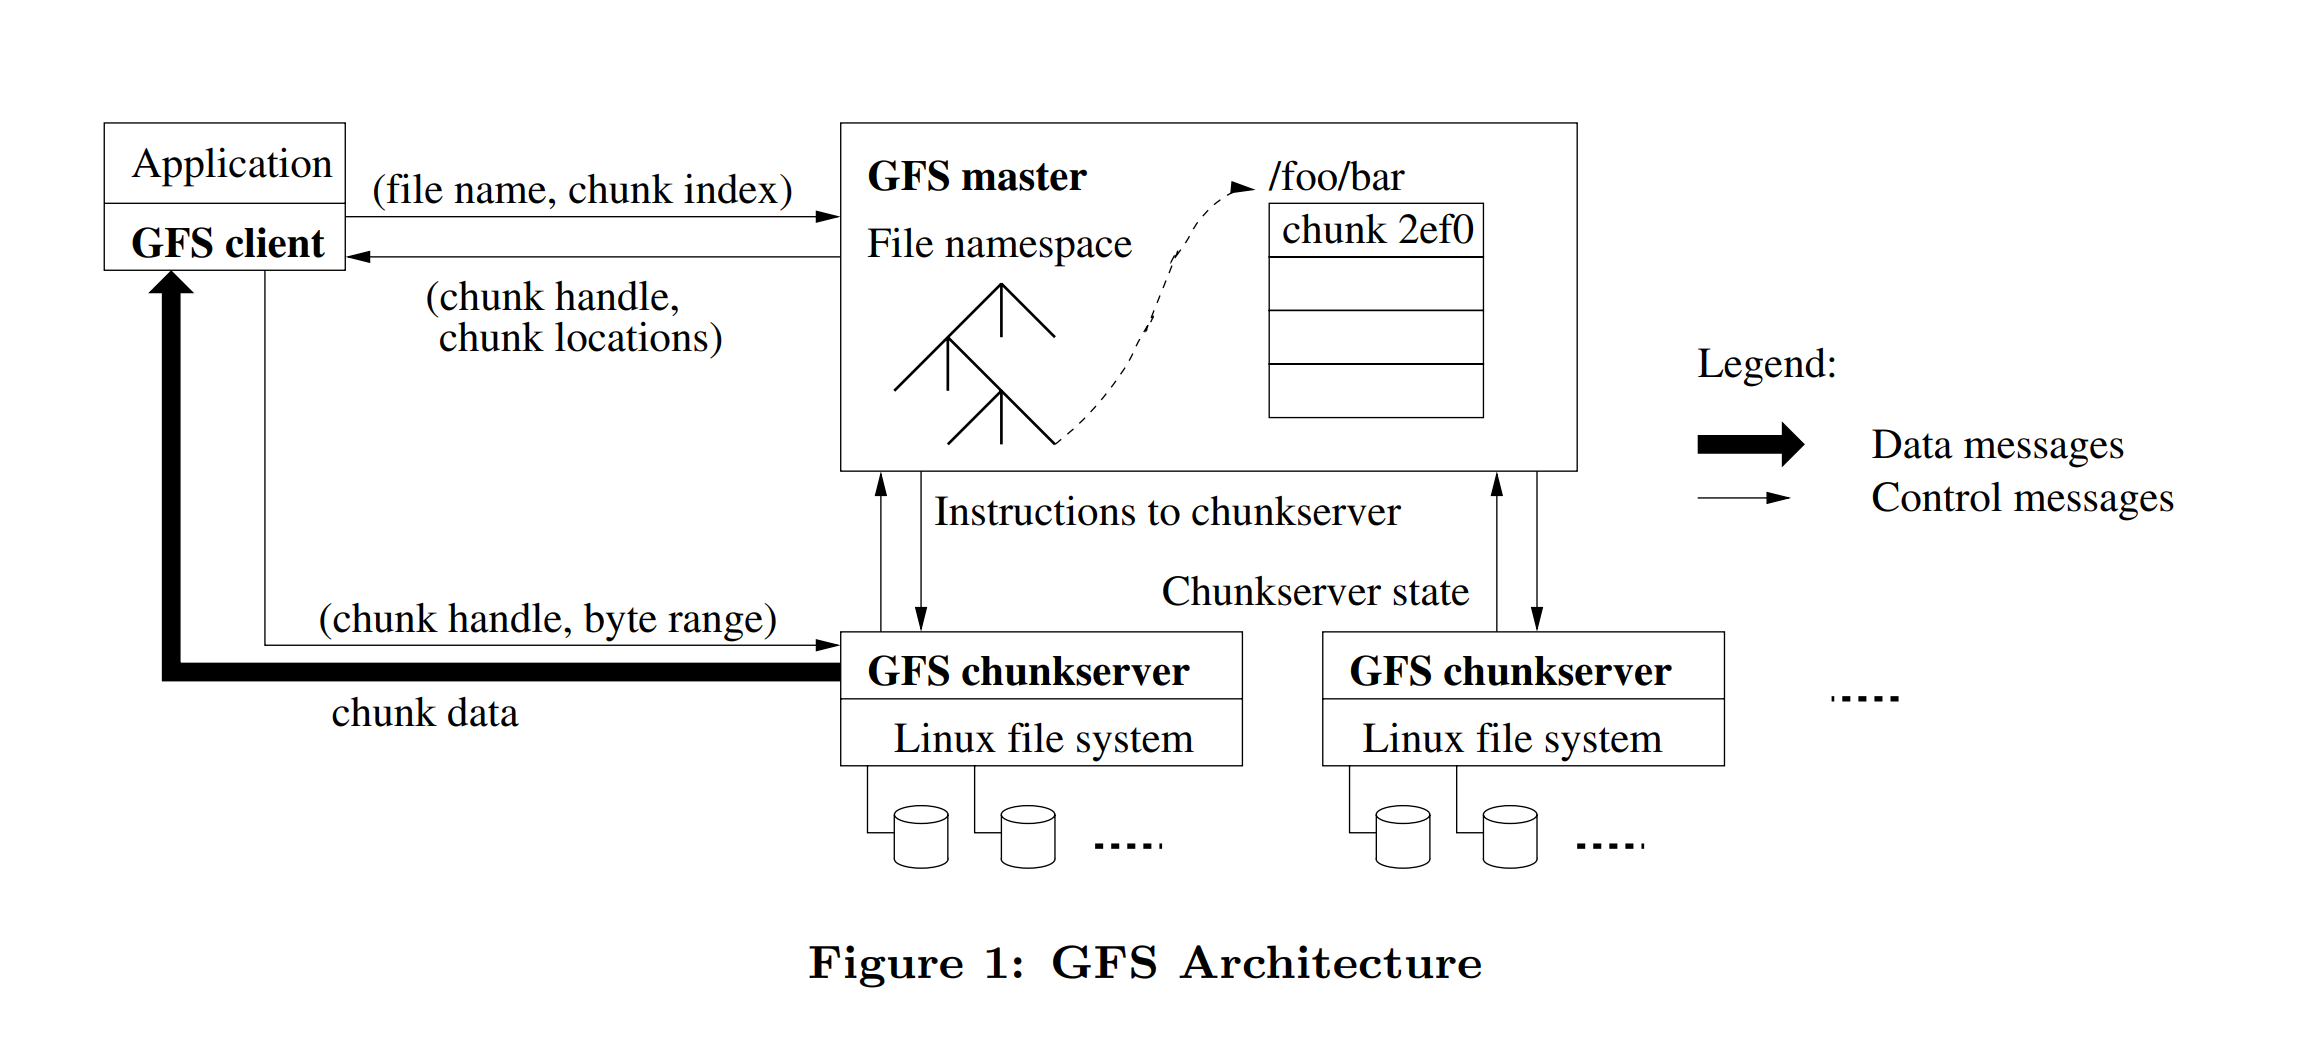
如图所示,GFS 集群是一个单主(master)多从(chunkserver)的结构,支持多用户同时接入。 chunk 指的是文件中固定大小的一段,master 在其初始化阶段会给它一个全局唯一 ID( chunk handle )。 chunkserver 会在本地 Linux 文件系统中存储 chunk,当然每个 chunk 会在多台 chunkserver 上留有备份。 master 保存文件系统的元数据,包括命名空间、准入信息、文件和 chunk 的映射关系,以及 chunk 的存储情况。
master 不负责文件读写,只是给 client 分配负责的 chunkserver,后者把该信息缓存下来方便后续操作。
举例来说,读操作可以拆解为如下步骤:
- client 根据固定的 chunk 大小,将文件名、读取位置翻译为该文件内的 chunk 索引;
- client 向 master 发送请求,询问该文件名和 chunk 索引所在的 chunkserver;
- master 返回 chunk 句柄和对应的 chunkserver(含冗余副本位置);
- client 缓存该信息,和其中的一个 chunkserver 进行交互,不再需要 master 介入。
为了减轻 master 压力,client 也可以一次性向 master 查询多个 chunk 的位置,后续操作便可以绕过 master。
master 在启动时、心跳时会从 chunkserver 处取得 chunk 位置。另外,集群元数据的变动会被记录在一个日志中,类似于 Redis 或之前 Raft 的机制,master 在 checkpoint 后能够重放日志以恢复自身状态。而每当日志增长到指定规模,master 都将更新一次 checkpoint。此时,为了避免阻塞,master 会新建一个日志文件,新开线程保存旧日志的 checkpoint。
一致性模型
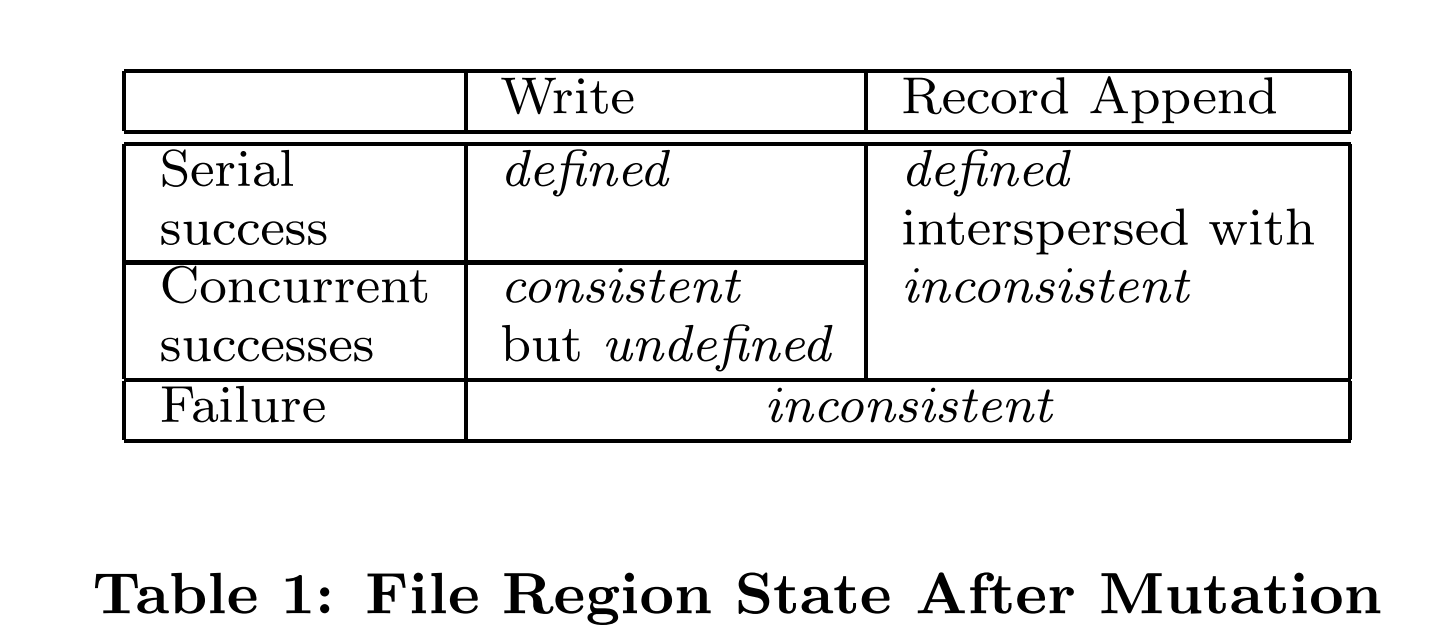
原论文中关于数据一致性有这样几个概念:
- consistent:所有的 client 都能观察到一样的数据,不论连接的是哪台 chunkserver;
- defined:数据首先能保证 consistent,且 client 能看到完整的数据变化(而不是并发写造成的片段,这种情况下,多个写操作的片段会混杂在一起)。
为了保证并发写时的数据行为是 defined,GFS 要确保至少一次原子写,它定义的 offset 会被返回给 client,而非使用后者认为的 offset。因此,GFS 中 chunk 并非是紧凑的,中间可能会有 padding 或者重复记录。
GFS 确保在每个 chunkserver 上,chunk 的变更顺序都是一致的,并且使用版本号来识别脏 chunk,这种 chunk 会被垃圾回收掉,不会交给 client 或参与后续变更。
系统交互
一次数据变更会发生在所有与之相关的 chunkserver 上,为了保证这些 chunkserver 上的变更数据顺序一致,GFS 还引入了 primary 的概念。我们可以把拥有同一个 chunk 的 chunkserver 视为一个小集群。master 会给其中一个 chunkserver 颁发租约,使其成为 primary。primary 会决定并发数据变更发生的顺序,其它 chunkserver 会按照这个顺序记录变更。
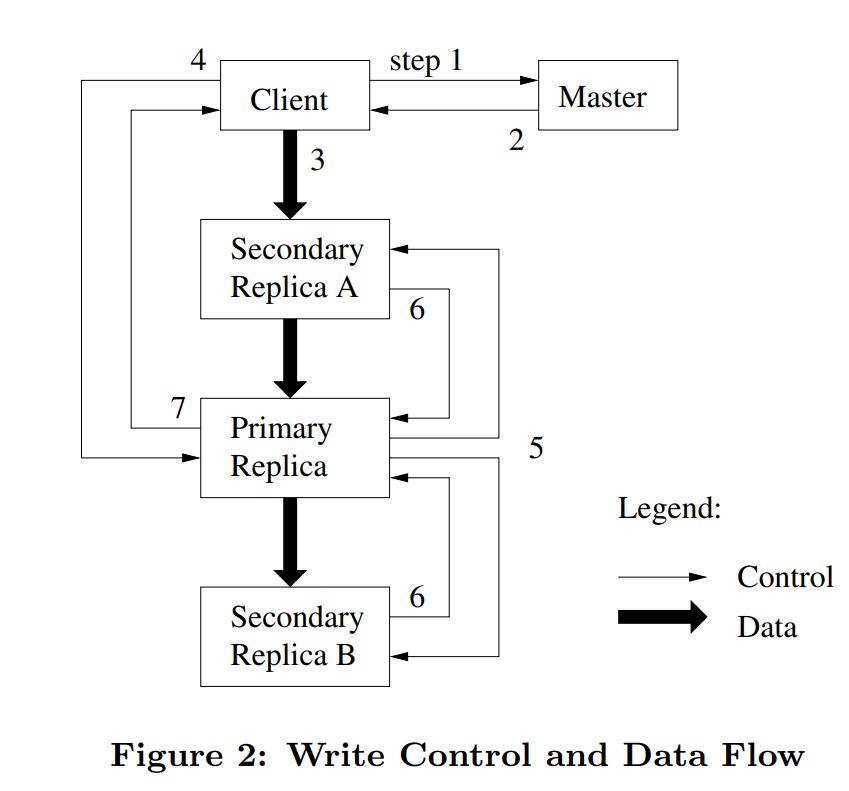
以上图为例,一次写操作的控制流是这样的:
- client 咨询 master,某特定的 chunk 在哪些 chunkserver 上。master 会返回 primary(目前拥有租约的 chunkserver)和其他从 chunkserver。如果目前没有 chunkserver 拿到租约,master 会在此刻发放租约;
- client 缓存 master 返回的信息,只有 primary 失去联系后它才会再次访问 master;
- client 将写操作的数据以任何顺序发送到所有的 chunkserver,chunkserver 会把数据缓存到 LRU 中;
- 所有的 chunkserver 都确认收到了数据后,client 再向 primary 发送和先前数据相对应的写操作请求。primary 会给它收到的并发写请求排序,并在本机实施写操作;
- primary 将写操作转发给所有的从 chunkserver,以确保大家的顺序都是一致的;
- 从 chunkserver 执行完了写操作,向 primary 确认;
- primary 告知 client 操作的执行结果。如果出现错误,client 会重试 3-7 步,因为错误大概率发生在从 chunkserver 处,如果实在不行,会从头开始重试。
GFS 的数据流和控制流是解耦的,即第三步数据的发送。为了最大程度利用网络带宽,每台机器都会向网络拓扑中最近的,还没有收到数据的机器转发数据。
Record Append
GFS 提供一种 record append 的原子化追加操作,即 client 只提供数据,GFS 决定 offset 位置,就像 Unix 中的 O_APPEND 模式。 否则,并发的 writer 就需要额外的锁机制来避免竞态条件。
要实现 record append,前文描述的控制流中需要做一些额外改动:在第 5 步中,primary 会检查追加数据是否会导致 chunk 超出限制,如果会,primary 干脆将 chunk pad 到最大大小,并令其它 chunkserver 也这么做。在此之后,它通知 client,写操作必须在下一个 chunk 上重试。
在从 chunkserver 上出现写失败,需要重试时,会继续在原数据基础上追加重试数据。因此,一个 chunk 中很可能出现多端重复数据,而 GFS 并不保证所有的 chunkserver 能够在字节级别做到完全一致,只保证至少有一次原子写。
master 涉及的操作
命名空间管理
为了支持多种操作并发进行,GFS 采用命名空间和锁来确保同一位置的操作序列进行。 GFS 并不具备文件系统的概念,它使用简单的 lookup table 将路径名和元数据进行映射。 master 的每次操作都需要获取对应的锁,如:操作对象是 d1/d2/d3/obj,则需要获取 d1、d1/d2、d1/d2/d3 的读锁,并根据操作类型获取 d1/d2/d3/obj 的读锁或者写锁。
副本管理
master 在创建一个 chunk,并决定分配它时会考虑如下几个因素:
- 要确保 chunkserver 的磁盘利用率大致均等;
- 要限制每台 chunkserver 上最近新建 chunk 的数量,因为新的 chunk 往往意味着大量的写操作;
- 要尽量将 chunk 的副本分散到不同机架上。
当一个 chunk 的副本低于 HA 阈值,master 就需要重新复制一个副本并分配,要考虑的因素和前面新建 chunk 时一致。
最后,master 会周期性地再分配 chunk,以平衡磁盘利用和负载均衡。
垃圾回收
GFS 的 GC 策略很简单:master 不知道的 chunk 都要被回收。
当一个文件被删除时,master 仅仅记录一条日志,将文件名更改为带有删除操作时间戳的隐藏名,而非马上回收对应的资源。 master 在周期性扫描命名空间时,会将超过三天的这类文件清除。另外,在类似的扫描过程中,master 会清理所有孤儿 chunk(没有与之对应的文件的 chunk)和与之对应的元数据。在心跳机制中,chunkserver 会被指示删除没有元数据的 chunk。